停车记录越攒越多,查报表越来越慢?先别急着换数据库
停车记录增加后报表变慢,先检查查询、索引和执行计划,再评估交易与分析业务分工。用实际样本验证分析数据库,并核对两套数据口径。
场景示意图,非实际项目照片或产品操作界面。
查一辆车的进出记录还算快,一导出整月报表,页面就开始转圈。再碰上多个车场同时查询,收费业务也跟着受影响。
这时很容易听到一个建议:换分析数据库。
分析型数据库有价值,但“查得慢”并不能单独证明现有数据库已经不够用。
先找出哪类查询慢,再决定需要优化还是分工。
01 先看请求 不要只看总记录数
一次查询是否限定车场和时间?是不是把几年图片和记录一起加载?分页有没有限制?关联表与索引是否匹配?
同样的数据量,查询方式不同,耗时可能差很多。日增量只是线索,不能作为换数据库的唯一门槛。
先收集慢查询、执行计划、资源占用和实际返回数据量。还要区分数据库等待、图片下载与前端渲染,不能把所有转圈都归给存储。
02 交易和分析 需要的能力不同
计费订单、退款、月卡状态等业务,需要正确处理状态变更和交易关系。
进出事件、设备日志、经营统计,则可能更偏向追加写入和范围聚合。停车数据不是全部“写了就不改”:纠错、申诉、退款都会产生后续变化。
先分业务,再分存储。不要为了报表,把交易正确性放到次要位置。
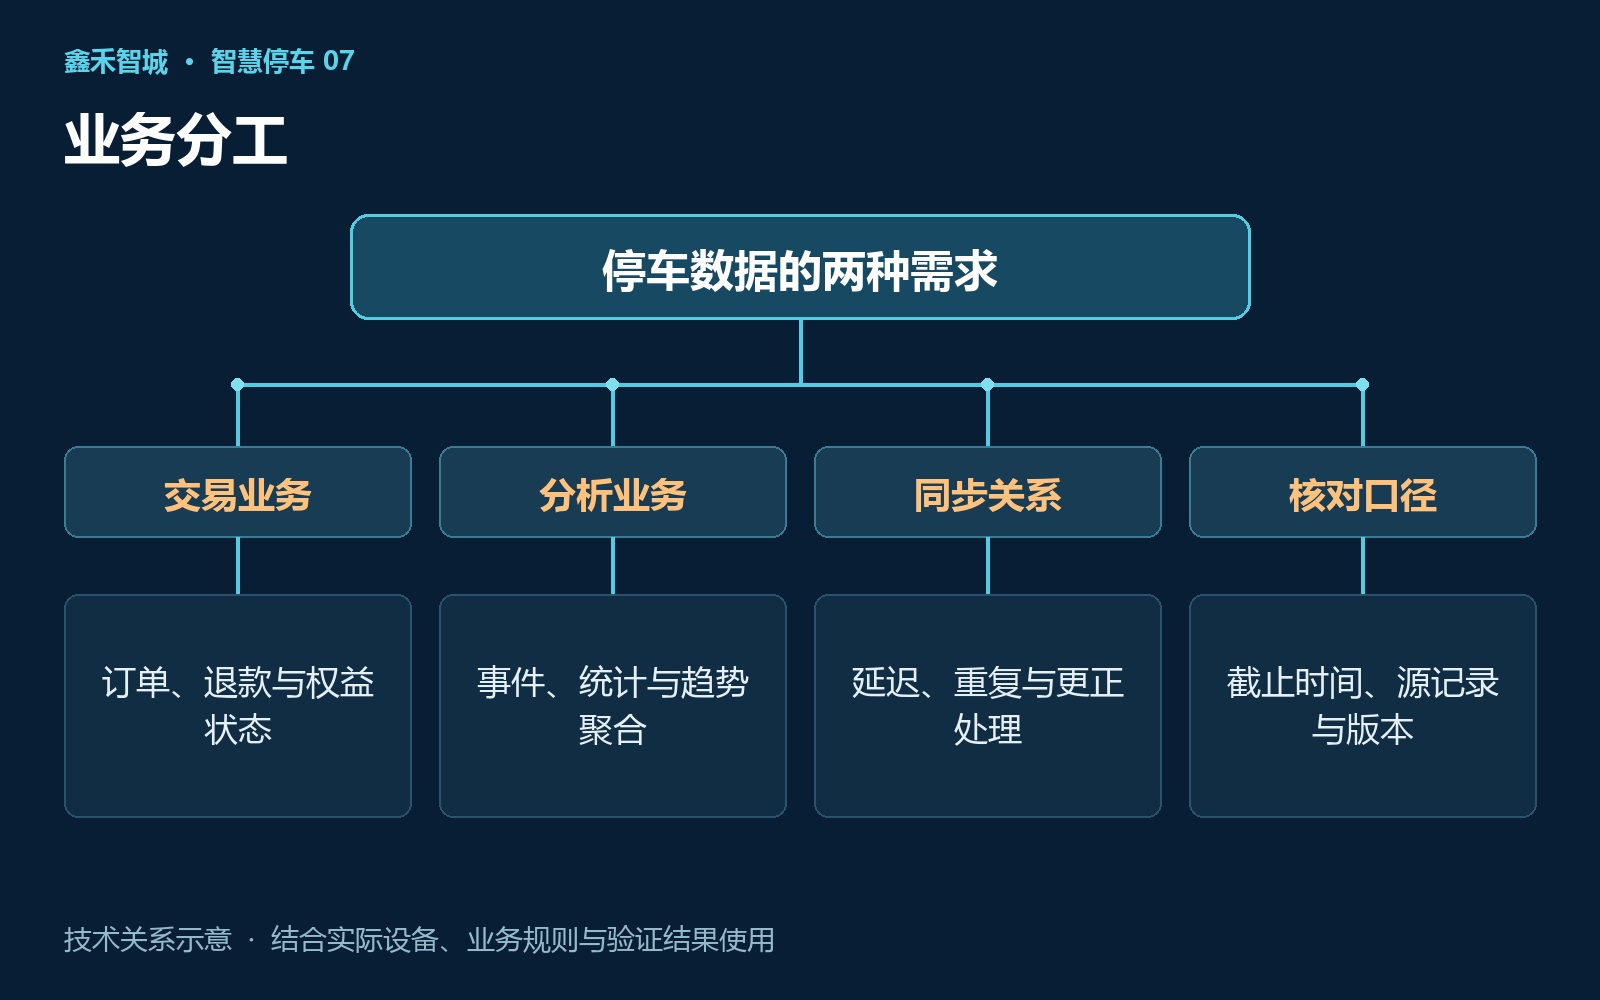
先分析读写模式,再决定是否拆出分析链路。
03 ClickHouse这类工具 适合解决什么
列式分析系统可以在批量读取部分字段、聚合统计等负载中发挥优势,但实际速度和压缩效果受数据、模型、硬件及查询影响。
它不是业务数据库的无条件替代品。是否能满足更新、事务和一致性需求,应结合具体版本、表引擎及实现核对。
需要独立分析链路时,可以保留交易主库,把适合的数据同步到分析系统;也可先评估索引优化、汇总表或只读副本等较轻方案。
04 表设计没有万能配方
宽表能减少部分关联,但也增加重复字段、维护和更正成本。是否使用,要看查询形态。
分区主要服务于数据管理和按条件裁剪,排序键等也会影响查询。不能一概要求按天分区;过细可能产生大量小分区和数据片段。
批量或异步写入可以减少小批次开销,但要同时安排延迟、失败处理与可观察性,不能只追吞吐量。
05 两套数据最容易差在哪里
同步可能延迟,也可能遇到重复、乱序、源数据更正和删除。分析报表应显示数据截止时间,并有可核对的口径。
例如退款发生后,经营分析怎样反映?旧记录更正后,历史汇总是否重算?业务要求删除的信息,分析副本是否同步处理?
报表快了却算不对,解决的是一个问题,又增加了另一个问题。
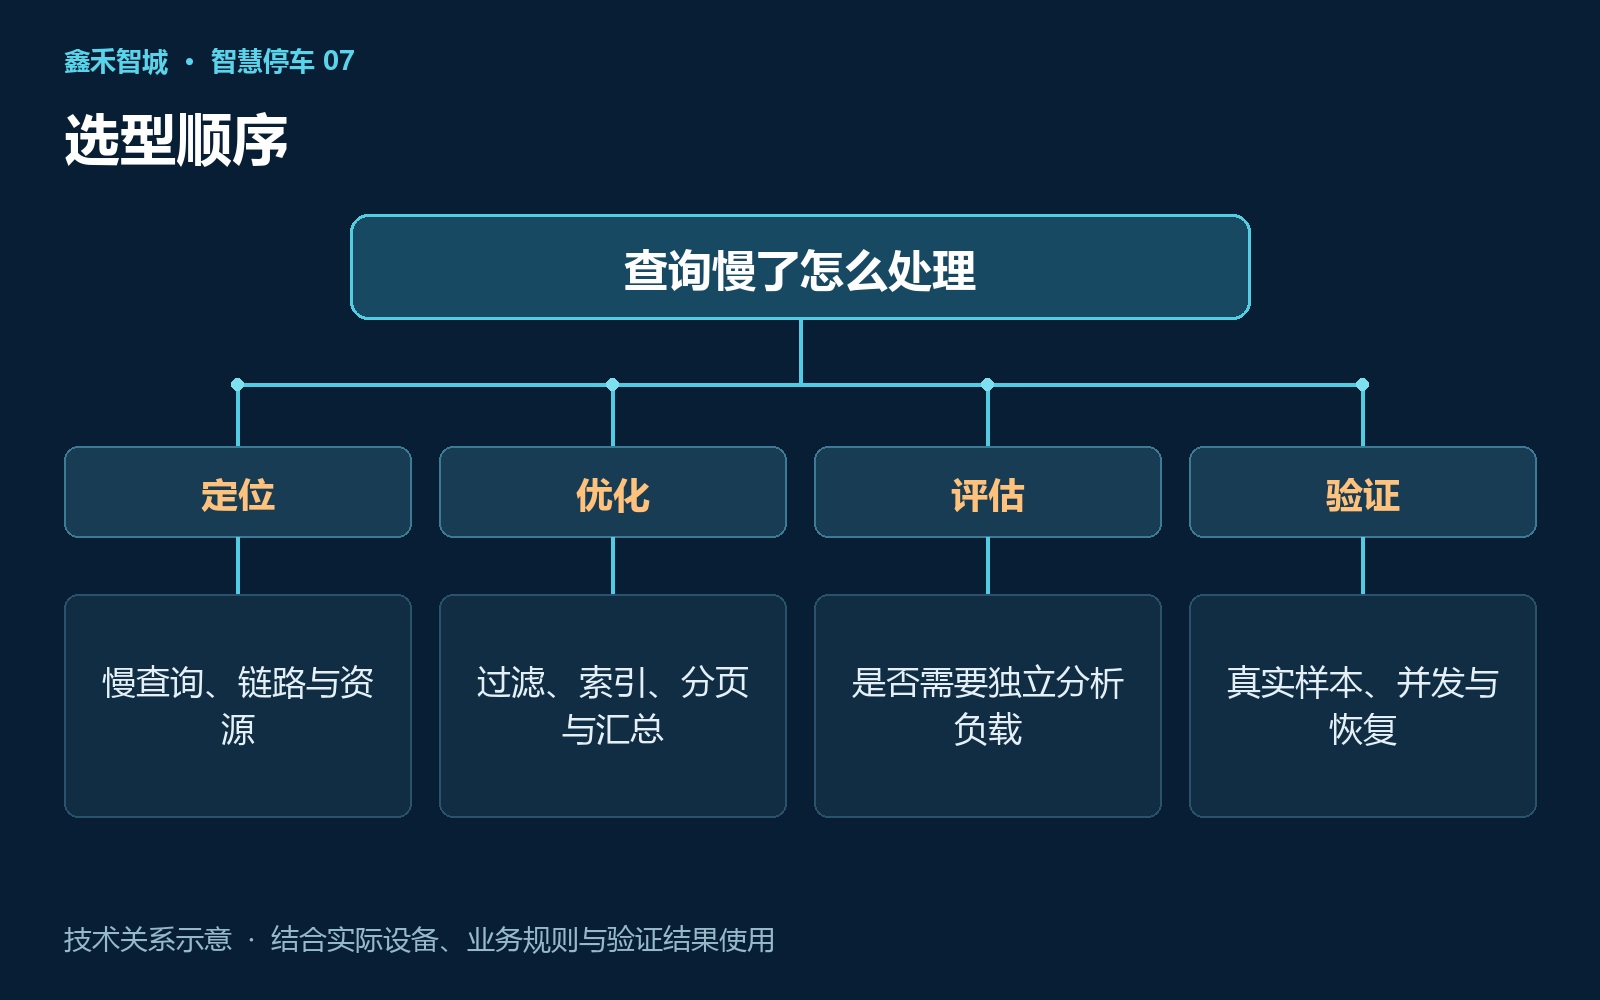
先测量与优化,确有独立分析需求时再增加系统复杂度。
06 选型时 用自己的样本验证
准备接近实际的数据结构、典型查询、峰值并发和更正场景,比较耗时、资源、运维工作量及恢复能力。
别把厂商示例里的毫秒级结果,当成项目承诺;也不要为了日后可能增长,提前部署没人能维护的复杂架构。
存得下、查得快、算得对、管得住,四件事要一起成立。
你们最慢的是查单车、导月报,还是做跨车场统计?先回答这个问题,优化方向会具体很多。
— 鑫禾智城 —
关注鑫禾智城,让停车数据的技术选择服务于实际业务。
参考:ClickHouse分区设计建议。配图为 AI 场景插画与原创技术图,均仅作示意。